
Sur le code et les agents autonomes, les modèles open source ne sont plus une option « budget ». L'écart avec les modèles fermés n'a pas disparu, mais il ne se mesure plus là où on le cherche.
Nous suivre


Ces derniers mois, j'ai pris l'habitude de tester chaque nouveau modèle ouvert sur mes vraies tâches. Pas sur des questions de culture générale : sur du code à modifier dans plusieurs fichiers, sur des tests à relancer jusqu'à ce qu'ils passent, sur des agents qui travaillent seuls pendant de longues sessions.
Avec GLM-5.3 de Z.ai, puis Kimi K3 de Moonshot AI, j'ai été bluffé. Ils tiennent la distance. Ils planifient, se trompent, corrigent, recommencent, et finissent le travail. Il y a un an, je n'aurais confié ce type de tâche qu'à un modèle fermé.
Mais le vrai choc est venu d'ailleurs. Qwen3.8-27B, un « petit » modèle de 27 milliards de paramètres, tourne entièrement sur ma machine. Pas de cloud, pas d'API, aucune donnée qui sort. Et sur une bonne partie de mes tâches de code, il tient la route.
Ce n'est plus « pas mal pour de l'open source ». C'est bien, tout court.
La question n'est plus de savoir si les modèles ouverts sont utilisables. Elle est de savoir sur quelles tâches leur retard coûte encore quelque chose.
Combien de temps les modèles ouverts ont-ils de retard sur les modèles fermés ? La réponse dépend de qui mesure, et comment.
Epoch AI, qui suit les capacités des modèles depuis plusieurs années, estime que depuis janvier 2026 les meilleurs modèles ouverts ont en moyenne environ quatre mois de retard sur les meilleurs modèles fermés. Quatre mois, à l'échelle de l'industrie, c'est un cycle de sortie.
L'AI Security Institute britannique arrive à une conclusion proche sur un terrain exigeant, la cybersécurité : GLM-5.2 et DeepSeek V4-Pro se comportent comme des modèles fermés sortis 4 à 7 mois plus tôt. En 2025, le même institut mesurait un retard de 6 à 10 mois.
À l'inverse, l'Arena, où des utilisateurs votent à l'aveugle entre deux réponses, montre un écart qui s'est creusé à l'été 2026.
Alors, l'écart se réduit-il ou non ? Il faut accepter une chose : aucun benchmark n'est parfaitement fiable.
On ne connaîtra donc jamais l'écart exact. Mais la tendance de fond, elle, se lit sans ambiguïté : chaque génération de modèles ouverts atteint le niveau que les modèles fermés avaient quelques mois plus tôt, et ce niveau suffit désormais pour une grande partie des usages réels. On peut utiliser un modèle ouvert en confiance sur beaucoup de tâches, ce qui n'était pas vrai il y a dix-huit mois.
Pendant longtemps, on a jugé un LLM sur ce qu'il savait. Connaît-il la date de tel événement, la syntaxe de telle bibliothèque, la jurisprudence de tel domaine ?
Ce critère a perdu une partie de son sens. Un agent n'a pas besoin de tout savoir s'il sait chercher. Il peut naviguer sur le web, lire la documentation, interroger une base de données, exécuter du code et observer le résultat.
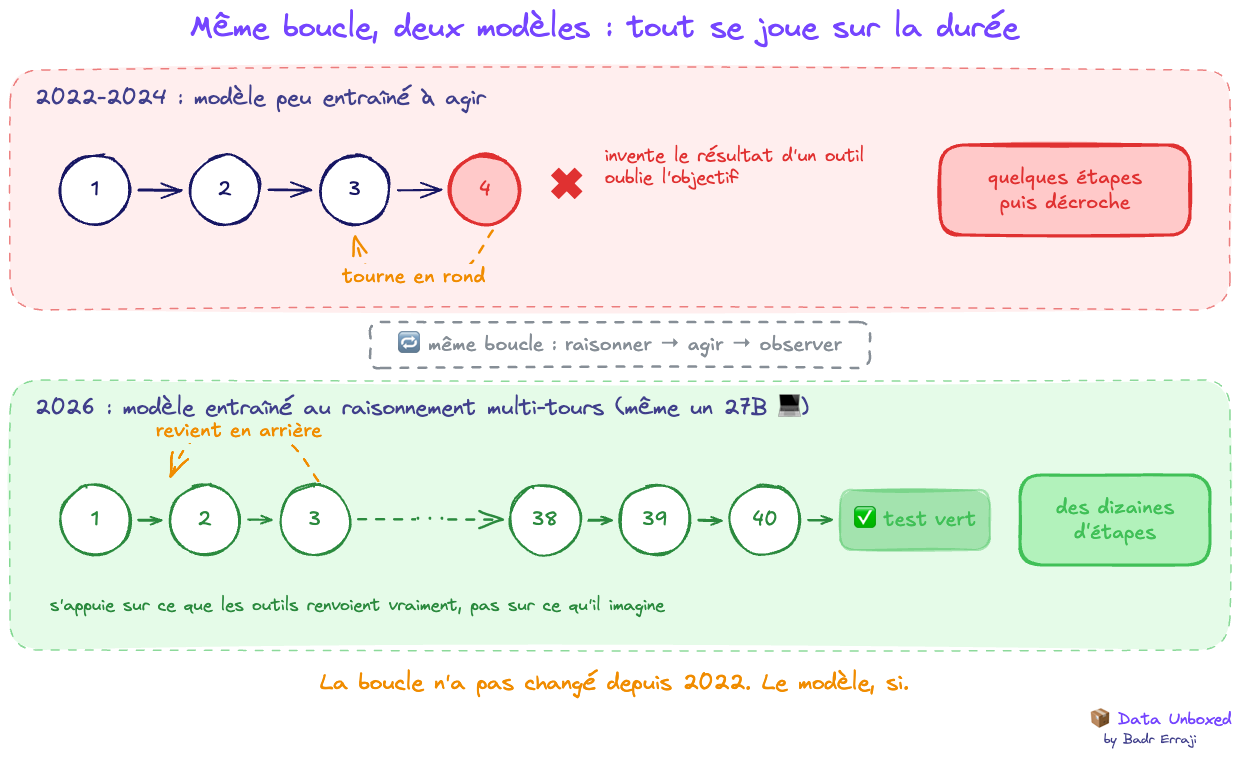
La boucle d'agent elle-même n'a rien de nouveau. Réfléchir, appeler un outil, lire le résultat, recommencer : le principe existe depuis 2022. Ce qui a changé, ce sont les modèles qu'on met dedans. Les premiers agents décrochaient au bout de quelques étapes : ils inventaient le résultat d'un outil, oubliaient l'objectif initial ou tournaient en rond.
Les modèles de cette année ont été spécifiquement entraînés au raisonnement sur plusieurs tours. Ils restent cohérents sur des dizaines d'étapes, s'appuient sur ce que les outils renvoient vraiment plutôt que sur ce qu'ils imaginent, et savent revenir en arrière quand une piste échoue. Et ce n'est plus réservé aux très gros modèles : même un petit modèle comme Qwen3.8-27B enchaîne des actions sans halluciner ni partir dans la mauvaise direction.
Les connaissances restent un atout. Un modèle qui maîtrise les concepts d'un domaine raisonne mieux, pose de meilleures hypothèses et sait quoi chercher. Mais l'essentiel de la valeur s'est déplacé vers cette capacité à tenir la distance.
C'est précisément là que les modèles ouverts ont fait leur plus grand bond cette année.
DeepSeek V4.1 Flash en est l'exemple le plus frappant. Sur DeepSWE, un benchmark où l'agent doit résoudre de vrais problèmes de développement logiciel de bout en bout, il atteint 74,2 % de réussite, contre 54,4 % pour la version précédente. Selon DeepSeek, c'est le niveau des meilleurs modèles fermés du moment, et une mesure indépendante confirme le score. Le tout pour un coût de quelques dizaines de centimes par tâche et avec un contexte d'un million de tokens. Très bon marché, et très performant sur les raisonnements longs.
GLM-5.3 montre une autre facette du progrès. Z.ai ne l'a pas réentraîné à partir de zéro : il s'agit uniquement d'un post-entraînement sur la version précédente. Pourtant, son score sur DeepSWE passe de 46 à 67. Sur Terminal-Bench 3.0, qui teste des tâches longues en ligne de commande, il passe de 4,6 à 28,3, à quelques points des meilleurs modèles fermés (autour de 34).
Kimi K3, enfin, a été conçu d'abord pour les agents : tenir de longues sessions d'ingénierie, naviguer dans de gros dépôts de code, orchestrer des outils en ligne de commande avec un minimum d'intervention humaine. C'est exactement ce que j'ai constaté en l'utilisant.
Le message est clair : sur le terrain qui compte le plus aujourd'hui, l'autonomie, les modèles ouverts ne jouent plus en deuxième division.
L'autre surprise de l'année se joue à l'autre bout de l'échelle : les petits modèles qui tournent sur un simple poste.
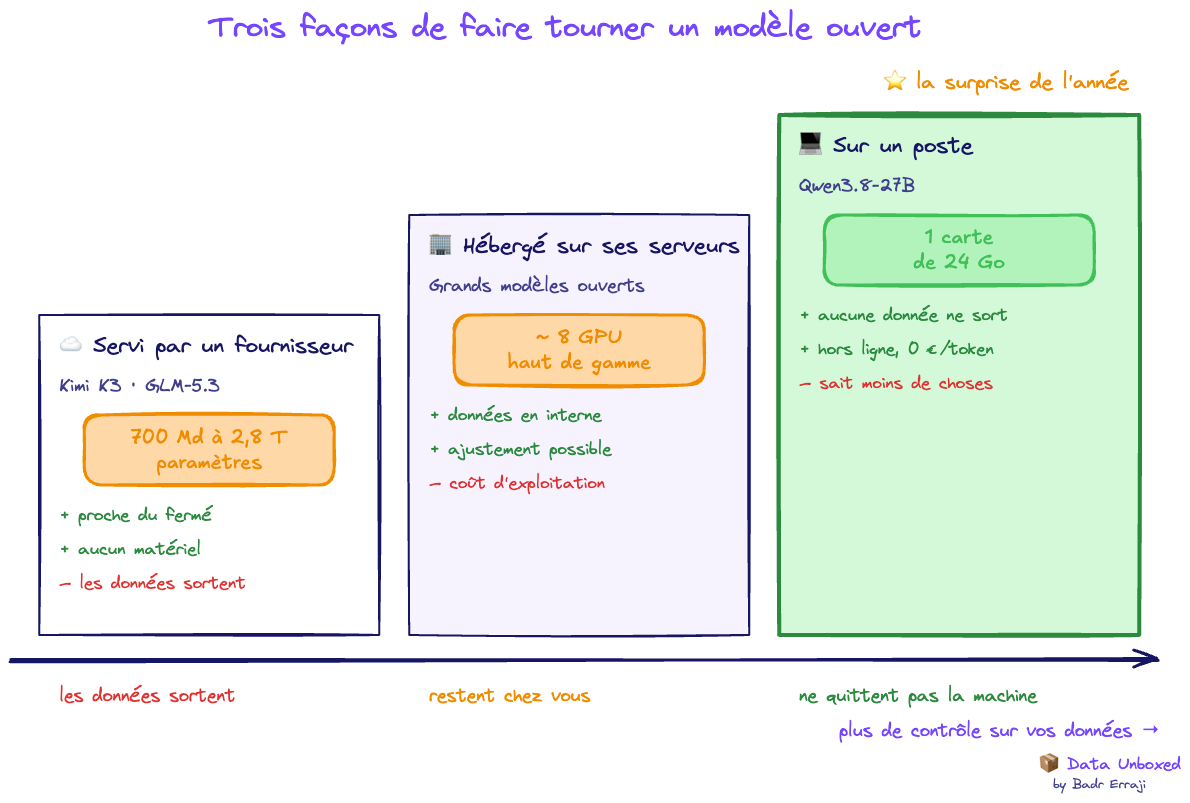
Qwen3.8-27B tient sur une seule carte graphique de 24 Go une fois compressé en 4 bits (environ 17 à 19 Go de mémoire). Il tourne aussi sur un ordinateur portable haut de gamme, à environ 15 à 30 tokens par seconde. Il est publié sous licence Apache 2.0, donc réellement ouvert, y compris pour un usage commercial.
Sur le code, ses progrès sont nets par rapport à la génération précédente de même taille : 73,0 sur Terminal-Bench 2.1 (contre 63,4) et 61,7 sur SWE-bench Pro (contre 53,5). Ces chiffres sont publiés par l'équipe Qwen elle-même et doivent être lus avec prudence, mais ils correspondent à ce que j'observe en pratique.
Pour une entreprise, l'intérêt dépasse la performance brute :
La limite est connue : un modèle de 27 milliards de paramètres sait moins de choses qu'un modèle de plusieurs centaines de milliards. Mais c'est là que l'agentique change la donne. Un petit modèle qui raisonne bien et sait chercher l'information compense en grande partie ce qu'il ne sait pas.
Plusieurs tendances se combinent.
L'enthousiasme ne doit pas faire oublier plusieurs réserves.
Le score dépend de l'environnement. Le même DeepSeek V4.1 Flash obtient 74,2 % sur DeepSWE avec un environnement d'agent minimaliste, mais 69,8 % ou 65,6 % avec deux assistants de code du marché. Un benchmark mesure un couple modèle et outillage, pas un modèle seul.
Les tests en conditions réelles déçoivent parfois. Plusieurs retours pratiques montrent des modèles qui trébuchent sur des tâches que leurs scores laissaient croire faciles. Rien ne remplace un test sur ses propres cas d'usage.
Les gros modèles restent lourds à héberger. Les poids de Kimi K3 pèsent environ 1,4 To, et GLM-5.3 demande de l'ordre de huit GPU haut de gamme. « Ouvert » ne veut pas dire « facile à faire tourner chez soi » : pour ces modèles, on passe le plus souvent par un fournisseur d'hébergement.
Toutes les licences ne se valent pas. Qwen3.8-27B est sous Apache 2.0, mais la licence de Kimi K3 impose des restrictions commerciales, notamment pour les gros revendeurs. Il faut la lire avant de bâtir un produit dessus.
Le haut de gamme reste fermé. Sur les tâches les plus difficiles, les meilleurs modèles fermés gardent quelques points d'avance. Et les laboratoires fermés disposent probablement de modèles internes plus avancés que ceux qu'ils publient.
La bonne approche n'est pas de choisir un camp, mais d'associer chaque type de tâche au bon modèle.

Ces critères recoupent aussi les exigences de souveraineté et de conformité, notamment avec l'AI Act européen : savoir où tournent les modèles et où transitent les données devient un argument de choix à part entière.
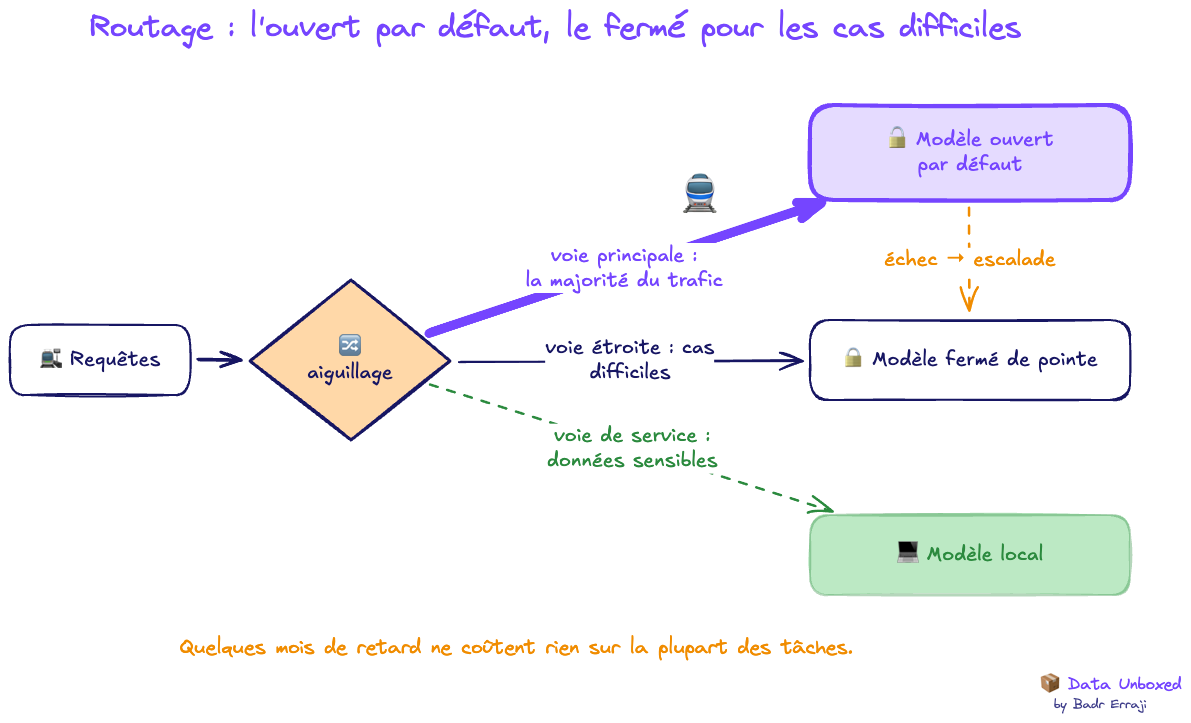
En pratique, l'architecture la plus efficace est souvent un routage : un modèle ouvert traite la majorité des requêtes, et seuls les cas difficiles ou les échecs sont envoyés vers un modèle fermé.
Il y a deux ans, choisir un modèle ouvert était un compromis assumé : moins bon, mais moins cher ou plus maîtrisé. Ce n'est plus le cas pour une grande partie des usages.
Les modèles ouverts ne sont pas encore à égalité avec les meilleurs modèles fermés. Mais ils sont assez proches pour changer la décision, surtout là où se joue la révolution de l'année : les agents qui raisonnent longtemps et agissent seuls. Et pour la première fois, une partie de cette capacité tient sur un simple poste de travail.
La question à se poser n'est donc plus « ouvert ou fermé ? », mais celle-ci :
Sur cette tâche précise, quelques mois de retard me coûtent-ils vraiment quelque chose ?
Le plus souvent, la réponse est non.
Article par B.ERRAJI, consultant data OSSIA - SONATE
🚀 Pour devenir AI Engineer, maîtrisez : Software Engineering, System Design, Machine Learning et LLM Engineering. Découvrez sa roadmap complète : https://www.dataunboxed.io/blog/roadmap-to-ai-engineering


Découvrez dans cet article les 4 technologies data qui, en 2025, simplifient et transforment radicalement notre manière de gérer les données.


